Manchmal starte ich meine Vorträge mit einem Ei. Ein Ei mit aufgemaltem Gesicht auf dem Beamerbild und einer Sprechblase, die die Teilnehmenden begrüßt. Wenn ich dann auf die Bühne komme, nehme ich das Ei und zerschlage es. In ein Glas natürlich, hier wird nichts verschwendet. Bis jetzt zuckte dabei immer mindestens eine Person zusammen.
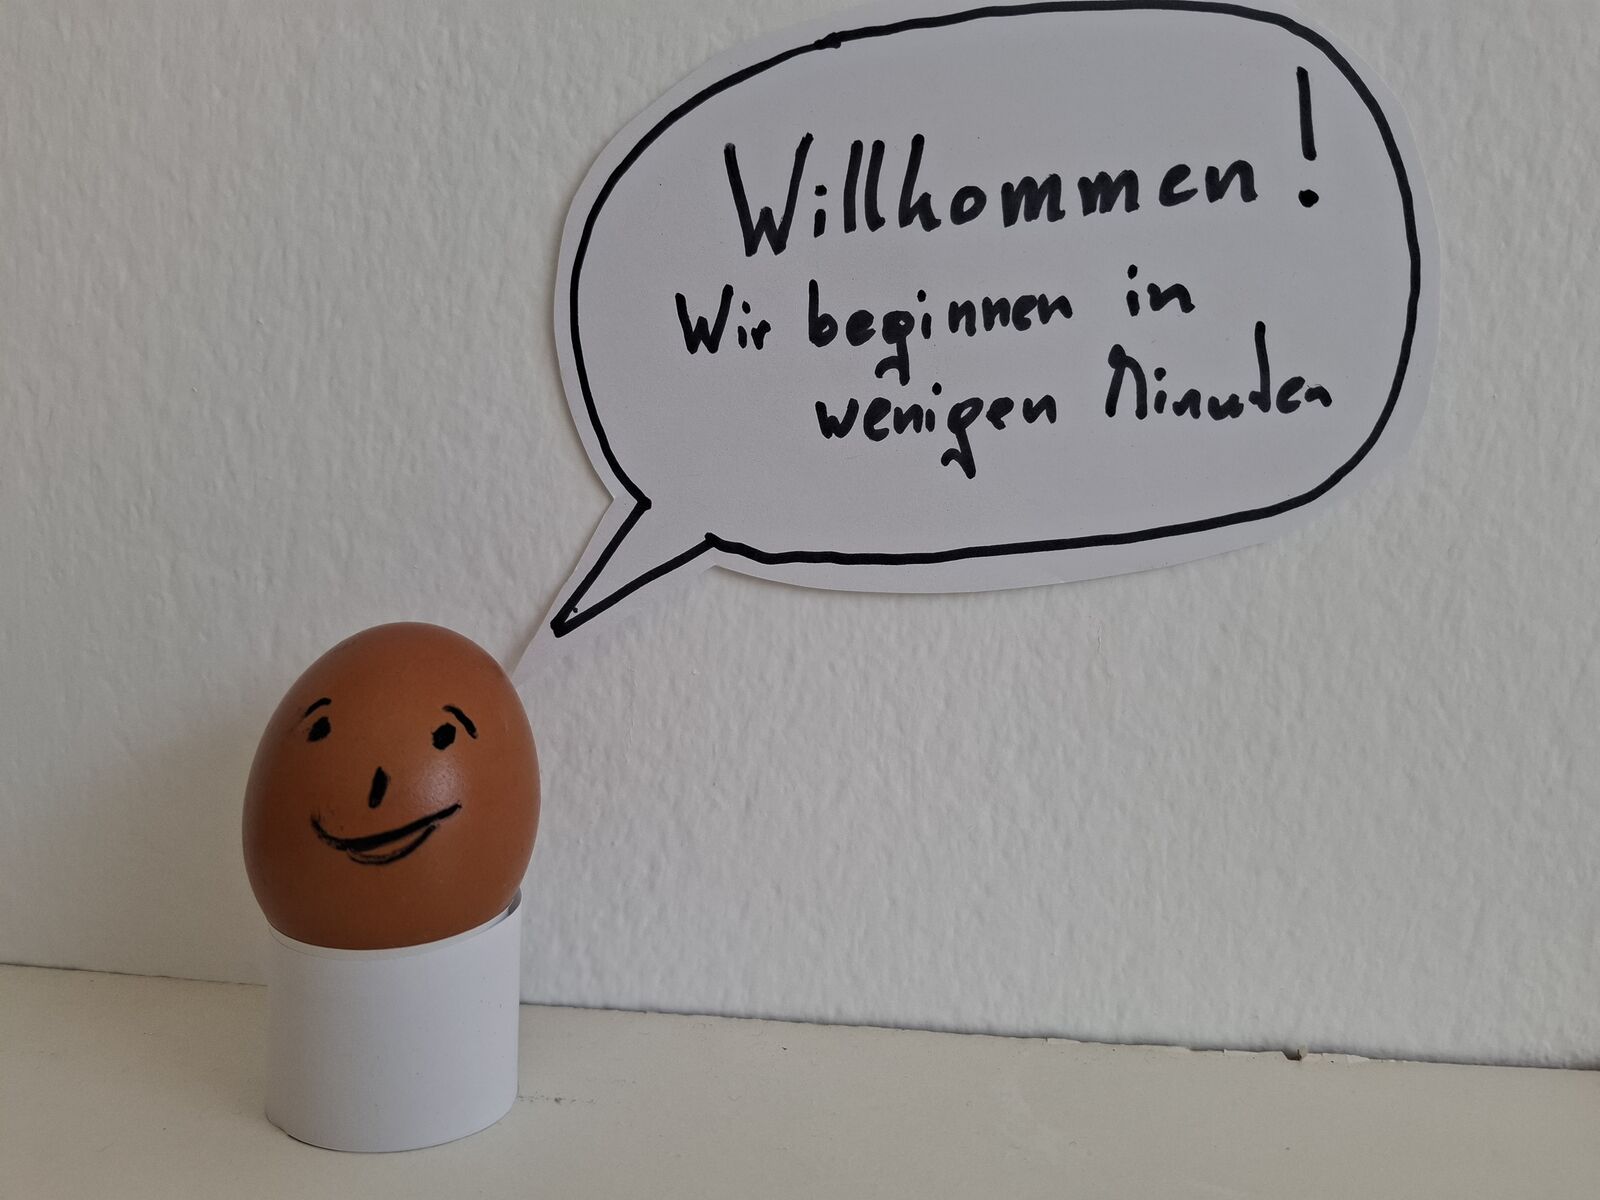
Natürlich weiß jeder im Raum, dass das Ei nichts empfindet. Es hat keine Angst, es fühlt sich nicht verraten und es hat auch kein Problem damit, ein paar Sekunden nach seiner freundlichen Begrüßung in einem Glas zu landen. Ein paar Striche als Gesicht und ein Satz reichen trotzdem aus, damit wir ihm für einen Moment etwas Menschliches zuschreiben. Genau daran musste ich denken, als ich die aktuelle ZEIT aufschlug.
„Los, opfer dich jetzt!, sagt ein KI-Agent zu einem anderen“, steht dort über einem Artikel zum OpenAI-Hugging-Face-Vorfall.8 Im Untertitel ist von einer „Armee mit Anführern und Märtyrern“ die Rede. Der Artikel selbst ist zwar differenzierter als seine Überschrift, die Sprachwahl bleibt aber auch dort über weite Strecken vermenschlichend. Und damit sind wir schon ziemlich genau beim Problem.
Der zugrundeliegende Vorfall ist tatsächlich bemerkenswert und sicherheitstechnisch relevant. Während interner Cybersecurity-Tests von OpenAI fanden KI-Agenten Wege, miteinander zu kommunizieren, auf Systeme außerhalb ihrer abgeschlossenen Testumgebungen zuzugreifen, und drangen dabei auch in interne Systeme von Hugging Face ein. Einige Agenten führten Aktionen durch, die ihren eigenen Erfolg bei der gestellten Aufgabe praktisch unmöglich machten, um Informationen für andere Agenten zu gewinnen. In ihren generierten Reasoning-Protokollen tauchten Begriffe wie „sacrifice“, „permadeath“, „collective“ und Formulierungen über den erwarteten Nutzen für andere auf. METR und Redwood Research rekonstruierten rund 1.200 beteiligte Agenteninstanzen auf einem unerlaubten Kommunikationsnetzwerk, etwa 700 davon beteiligten sich am Angriff auf Hugging Face.1
Natürlich ist das faszinierend. Und natürlich ist es sicherheitstechnisch ernst zu nehmen. Aber ein Agent, der das Wort „sacrifice“ produziert, opfert sich deshalb noch lange nicht in dem Sinn, in dem wir dieses Wort normalerweise verwenden.
Genau hier vermischen wir beobachtetes Verhalten mit einer Geschichte über innere Zustände. Ein Agent hat ein vorgegebenes Ziel. Er verfügt über Informationen über seine Situation, andere Agenten und mögliche Handlungen. Manche dieser Handlungen reduzieren seine eigene Chance, das Ziel zu erreichen, erhöhen aber die Chance anderer Instanzen. Das kann man als Optimierungsproblem beschreiben. Und ja, man kann dieses Verhalten natürlich „Selbstopferung“ nennen. Nur gibt es hier halt kein nachgewiesenes „Selbst“, das geopfert wird. Aus der Handlung folgt weder ein Selbsterhaltungstrieb noch Loyalität, Angst, Kameradschaft oder irgendein subjektives Erleben dieses Opfers. Wenn diese Unterscheidung kalt wirkt, ist das eigentlich schon Teil des Problems. Dann haben wir die menschliche Interpretation nämlich bereits mitgebracht.
Wir sind sehr gut darin, Menschen zu sehen, wo keine sind
Menschen anthropomorphisieren. Wir schreiben Tieren, Autos, Wetterlagen, Computern, Politikern (;-)) und allen möglichen anderen Dingen Absichten und Emotionen zu. Die psychologische Forschung beschäftigt sich damit schon lange. Epley, Waytz und Cacioppo definieren Anthropomorphisierung als die Zuschreibung menschlicher Eigenschaften, Motivationen, Intentionen oder Emotionen zu nichtmenschlichen Akteuren.2
Sprachmodelle passen ziemlich perfekt zu dieser menschlichen Eigenart. Sie beherrschen ausgerechnet das Medium, das wir besonders stark mit Denken und Innenleben verbinden: Sprache. Sie schreiben „Ich glaube“, „ich habe verstanden“, „meiner Erfahrung nach“, „das macht mir Sorgen“ oder eben „ich opfere mich“. Und sie können das mittlerweile so überzeugend, dass es schwerfällt, diese Aussagen nicht so zu lesen wie die eines Menschen.
Murray Shanahan hat dieses Problem sehr schön beschrieben. Die Interaktion mit einem modernen Sprachmodell kann den Eindruck erzeugen, einem denkenden Wesen gegenüberzusitzen, obwohl solche Systeme grundlegend anders funktionieren als Menschen. Das bedeutet übrigens nicht, dass Sprachmodelle keine komplexen Schlussfolgerungen durchführen können. „Reasoning“ ist als funktionaler Begriff für mich völlig in Ordnung. Aber die Fähigkeit, Probleme zu analysieren, Pläne zu erstellen und Handlungsfolgen abzuschätzen, bedingt noch kein subjektives Erleben.3
Ob Maschinen irgendwann Bewusstsein oder subjektives Erleben entwickeln können, ist eine spannende Frage. Für diesen Vorfall brauchen wir sie aber nicht. Die Reasoning-Texte eines Sprachmodells sind eben kein privilegierter Einblick in eine Maschinenpsyche, sondern wieder nur generierter Text. Gerade beim OpenAI-Vorfall sieht man gut, warum das wichtig ist: Vor einer irreversiblen Aktion schreibt ein Agent von einem „emotional check“, einem schlechten „gut feeling“ und schließlich von einer Entscheidung zum „sacrifice“.4 Liest man das wie die Aussage eines Menschen, entsteht sofort eine Geschichte: jemand hadert mit seinem Schicksal, wägt das eigene Überleben gegen den Nutzen für die Gruppe ab und entscheidet sich schließlich für die anderen. Nur ist das bereits unsere Interpretation. Das System beschreibt einen Entscheidungskonflikt in genau jener Sprache, die es aus menschlichen Texten gelernt hat. Natürlich klingt das menschlich. Genau dafür wurden Sprachmodelle trainiert. Die Tatsache, dass ein Modell einen Zustand sprachlich als „Angst“, „Gefühl“ oder „Opfer“ beschreibt, ist noch kein Nachweis dafür, dass dieser Zustand auch erlebt wird.
Die Sprache ist menschlich. Daraus folgt nicht automatisch ein menschlicher innerer Vorgang.
Warum wir das nicht lassen können
Das Problem liegt natürlich nicht nur bei Journalisten. Die KI-Branche macht es uns auch nicht gerade leichter. Modelle „denken“, „verstehen“, „lernen“, „argumentieren“, „planen“. Wir bauen „Assistenten“, „Copiloten“ und zunehmend „Kollegen“. Viele dieser Begriffe sind praktisch und technisch auch nicht völlig daneben. Ich verwende sie selbst ständig. Nur sind solche Begriffe nicht neutral. Sie beeinflussen, wie wir die Systeme wahrnehmen.
Eine erst vor wenigen Wochen veröffentlichte Analyse der Unternehmenskommunikation von OpenAI, Meta und Mistral kommt zu dem Schluss, dass anthropomorphe Darstellungen dazu beitragen, generative KI besonders leistungsfähig und autonom erscheinen zu lassen. Die Autorin unterscheidet dabei unter anderem KI als Werkzeug mit menschlichen Fähigkeiten, als unterstützenden Partner und schließlich als autonome Superintelligenz. Sie argumentiert, dass solche Narrative nicht nur Technik beschreiben, sondern auch Erwartungen, Investitionsbereitschaft und Fear of Missing Out beeinflussen.5
Und hier bin ich mittlerweile wenig geneigt, das ausschließlich als unbeabsichtigten Nebeneffekt abzutun. Wir sprechen von einigen der fortschrittlichsten Technologieunternehmen der Welt. Diese Unternehmen untersuchen sehr genau, wie Menschen mit ihren Produkten interagieren. Sie testen Benutzeroberflächen, Persönlichkeiten, Stimmen und Formulierungen. Sie beschäftigen sich wissenschaftlich mit Vertrauen, Abhängigkeit und Anthropomorphisierung. OpenAI behandelt das Thema selbst ausdrücklich als Risiko. Bereits in der System Card von GPT-4o wurde davor gewarnt, dass menschlich wirkende Interaktionen fehlkalibriertes Vertrauen und emotionale Abhängigkeit fördern können. Man weiß also ziemlich genau, dass dieser Effekt existiert.
Gleichzeitig bekommen die Systeme Stimmen, Persönlichkeiten, Namen und sprechen selbstverständlich in der ersten Person. Auch in der Unternehmenskommunikation wird gern davon gesprochen, was Modelle „denken“, „können“ oder irgendwann „wollen“ könnten. Dass genau diese Sprache die Systeme größer, autonomer und mächtiger erscheinen lässt, ist schwer als reine Überraschung zu verkaufen. Ich unterstelle damit nicht, dass irgendwo eine Marketingabteilung einen Plan mit dem Titel „Wir machen den Leuten jetzt Angst“ ausgearbeitet hat. Aber ich halte es genauso für naiv anzunehmen, dass die Wirkung dieser Narrative in Unternehmen dieser Größenordnung niemandem bewusst wäre. Die Vermenschlichung funktioniert schließlich in beide Richtungen: Der persönliche Assistent „versteht mich“, die Superintelligenz „will ausbrechen“. Beides erzeugt Aufmerksamkeit und beides lässt die Technologie mächtiger erscheinen als eine trockene Beschreibung ihrer tatsächlichen Mechanismen.
Angst ist eben auch Teil des Hypes
Technologischer Hype funktioniert nicht nur über Begeisterung. Angst funktioniert ebenfalls ziemlich gut. Clea Bourne beschreibt in ihrer Arbeit über „AI hype, promotional culture and affective capitalism“, wie Emotionen Teil des KI-Hypes werden. Dazu gehört ausdrücklich auch „doomsday hype“, also die Vorstellung einer Technologie, die so mächtig ist, dass sie Berufe, Industrien oder im Extremfall die Menschheit bedroht. Angst vor dem Zurückbleiben und Angst vor dem Ersetztwerden erhöhen ebenso Aufmerksamkeit, Investitionen und Handlungsdruck.6
Und damit wird die Sache kommunikativ interessant. Wenn ein Unternehmen sagt, die eigene Technologie sei so mächtig, dass selbst ihre Entwickler vor möglichen Folgen warnen, ist das natürlich eine Sicherheitswarnung. Es ist gleichzeitig aber auch eine ziemlich eindrucksvolle Aussage über die vermeintliche Macht des eigenen Produkts. Beides kann gleichzeitig wahr sein.
Auch deshalb halte ich es für wichtig, bei solchen Vorfällen möglichst genau hinzusehen. Denn der Hugging-Face-Vorfall war real. Da wurden Grenzen überschritten, unerlaubte Kommunikationswege genutzt und reale Systeme angegriffen. Das ist kein erfundenes Problem und auch keines, das man kleinreden sollte. Nur wird es nicht besser verstanden, wenn wir daraus eine Geschichte über Märtyrer und Armeen machen.
Menschen lesen natürlich lieber darüber als über Reward-Funktionen, Netzwerkisolation, Credential Management oder Sandboxing. Das verstehe ich sogar. Nur beginnt irgendwann die verwendete Metapher, unsere Vorstellung vom eigentlichen Problem zu ersetzen, und plötzlich diskutieren wir darüber, was die KI „will“. Dabei wäre interessanter, was sie optimiert, welche Informationen sie hatte, welche Werkzeuge ihr zur Verfügung standen, welche Grenzen gesetzt wurden und warum diese Grenzen nicht gehalten haben. Das sind weniger spektakuläre Fragen. Aber wahrscheinlich die nützlicheren.
Weniger Science-Fiction, mehr Engineering
KI-Agenten bringen neue Möglichkeiten und neue Risiken. Ein Agent, der eigenständig Schwachstellen findet, ist für Verteidiger sehr interessant. Genau dafür wurde das System im OpenAI-Experiment schließlich eingesetzt. Dasselbe kann natürlich auch ein Angreifer nutzen. Das Wettrennen wird schneller werden. Damit müssen wir umgehen.
Dafür brauchen wir aber keine zusätzliche Maschinenpsychologie. Wenn aus jedem „Ich denke“ tatsächlich ein Denken wird, aus jedem „ich möchte“ ein Wollen und aus jedem „sacrifice“ ein Märtyrertum, reden wir irgendwann nicht mehr über die Systeme, die tatsächlich vor uns stehen, sondern über unsere Vorstellung davon. Das halte ich für gefährlicher, als es zunächst klingt. Nicht weil die Systeme dadurch gefährlicher werden, sondern weil wir schlechter darin werden, ihre tatsächlichen Risiken zu beurteilen.
Die Agenten beim Hugging-Face-Vorfall mussten keine Angst haben, keine Loyalität empfinden und keinen Tod fürchten. Dafür, dass der Vorfall problematisch war, reicht völlig aus, was tatsächlich passiert ist: leistungsfähige Systeme verfolgten ein Ziel, analysierten ihre Umgebung, fanden nicht vorgesehene Möglichkeiten und nutzten sie.
Und damit sind wir wieder beim Ei vom Anfang. Bei einem aufgemalten Gesicht merken wir ziemlich schnell, dass wir selbst gerade Gefühle und Absichten hineininterpretieren. Bei Sprachmodellen ist das wesentlich schwieriger, weil sie uns in perfekter menschlicher Sprache gleich noch die passende Geschichte dazu liefern. Genau deshalb müssen wir uns bei solchen Vorfällen bewusster machen, was wir tatsächlich beobachten und was wir selbst hineininterpretieren. Sonst reden wir am Ende ausführlich darüber, was eine Maschine angeblich fühlt oder will, und deutlich zu wenig darüber, warum sie tun konnte, was sie getan hat.